pipeline()

Função pipeline()

Funcionamento:

Biblioteca função pipeline(), conecta os passos do seu modelo, exemplo abaixo:

Esse modelo utiliza um modelo pré-treinado e ajustado(fine-tuned) e analisa sentimentos dos textos em ingles.

Na função pipeline() exitem outras funcionalidades, como:

  • feature-extraction (pega a representação vetorial do texto)
  • fill-mask (preenchimento de máscara)
  • ner (reconhecimento de entidades nomeadas)
  • question-answering (responder perguntas)
  • sentiment-analysis (análise de sentimentos)
  • summarization (sumarização)
  • text-generation (geração de texto)
  • translation (tradução)
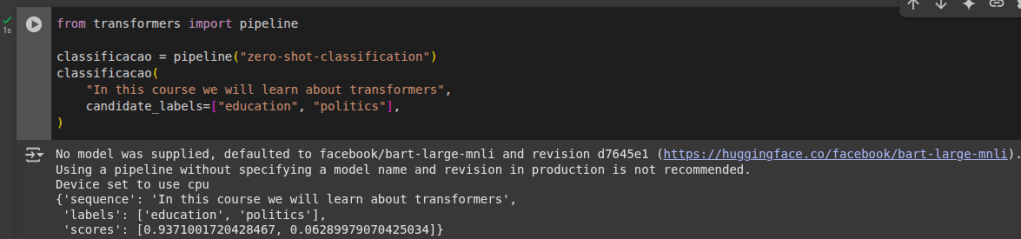
  • zero-shot-classification (classificação “zero-shot”)

Exemplo da função pipeline com zero-shot. Essa pipeline zero-shot você especifica quais rotulos deseja utilizar, escolhendo especificamento nos modelo já treinados, sem precisar fazer ajuste fino do modelo nos seus dados e já retorna os scores na lista de rótulos que você escolheu.

Text-generation (geração de texto):

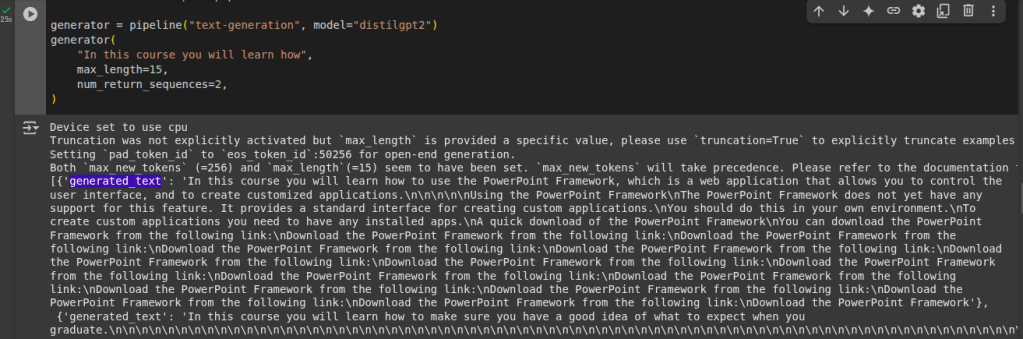
Nesse pipeline text-generation você passa um trecho de um texto e o modelo irá completar o restante.

Pode adicionar tambem os argumentos num_return_sequences (a quantidade de diferentes sequências são geradas) e o argumento max_length (tamanho máximo da saida-output).

Escolha de modelo no HuggingFace: https://huggingface.co/models

filtrar modelos por tarefas especificas:

Tarefas especificas e em outro idioma ou multi-lingual:

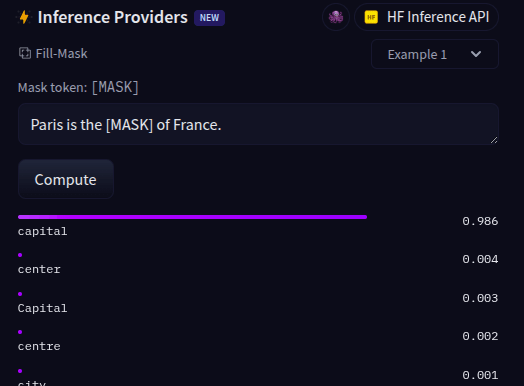
Fill-mask (preenchimento de máscara)

O pipeline mask-filling preenche algum espaço em branco por um texto:

OBS: a variavel <mask>, pode variar o modo como é chamada, exemplo no modelo bert é [MASK], verifique no modelo API antes https://huggingface.co/models?pipeline_tag=fill-mask&sort=trending
Exemplo em portugues:

NER (Reconhecimento de Entidades Nomeadas)

Reconhece as entidades, como nome, cidade, local trabalho.

no ner a função “grouped_entities=True” diz para agrupar em uma unica palavra uma entidade em uma, exemplo: “Data Science”

PER:Pessoa/Nome

LOC: Local

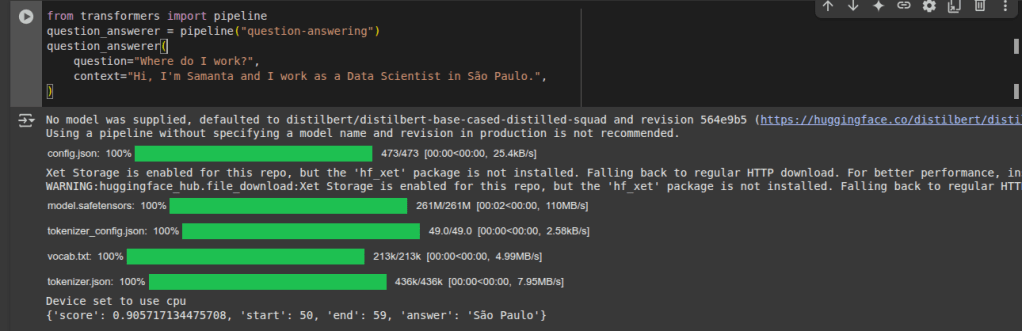
question-answering (extrai a resposta da pergunta)
summarization (sumarização)

Reduz o texto para um texto menor, o resumo escolhe partes importantes do texto

Tradução (translation)

Todos os códigos estão no github: https://github.com/samantaleke/LLM/blob/main/pipeline.py

Análise Estatística Espacial

“A cartografia é a ciência e arte de criar, estudar e comunicar informações espaciais por meio de mapas, cartas e outras representações gráficas da superfície terrestre. É uma disciplina que combina conhecimentos de geografia, matemática, informática e outras áreas, para representar e analisar dados espaciais de forma precisa e eficaz. “. Site: https://pt.wikipedia.org/wiki/Cartografia, acesso 15 de maio de 2025.

“Geotecnologia, conjunto de tecnologias para coleta, processamento, análise e disponibilização de informação geográfica. A Geotecnologia envolve aplicação de tecnologias da informação e comunicação para a aquisição, processamento, análise e visualização de dados geoespaciais. Este campo interdisciplinar desempenha um papel crucial em diversas áreas do conhecimento, incluindo geografia, cartografia, geologia, biologia, agricultura, planejamento urbano e gestão de recursos naturais.”. Site: https://pt.wikipedia.org/wiki/Cartografia, acesso 15 de maio de 2025.

Escolha do sistemas de coodenadas.

é uma superfície matematicamente definida que se aproxima do geoide, a verdadeira figura da Terra ou qualquer outro corpo planetário

Fonte: IBGE

Fonte: https://www.ufsm.br/midias/arco/cartografia-inclusiva – acesso: 15 de maio de 2025.

Escolha a escala:

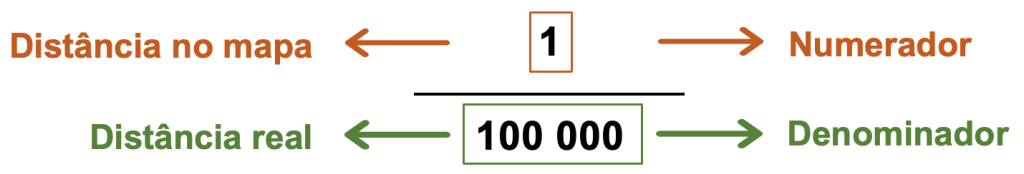
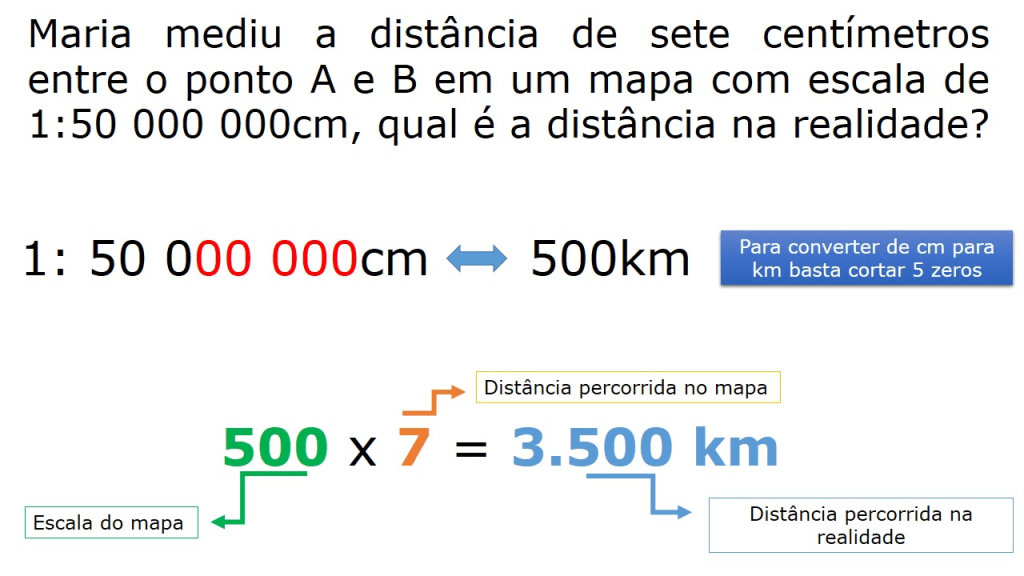
Calculo da escala:

Sazonalidade

Variações regulares e periódicas na média da série, repetições ao longo de um dia, uma semana ou um ano são comuns.

As variações geralmente são ocorrem devido a aspectos do comportamento humano ou ciclos naturais ou comportamentos convencionais da sociedade. Ex. Transito durante a semana e horários de picos.

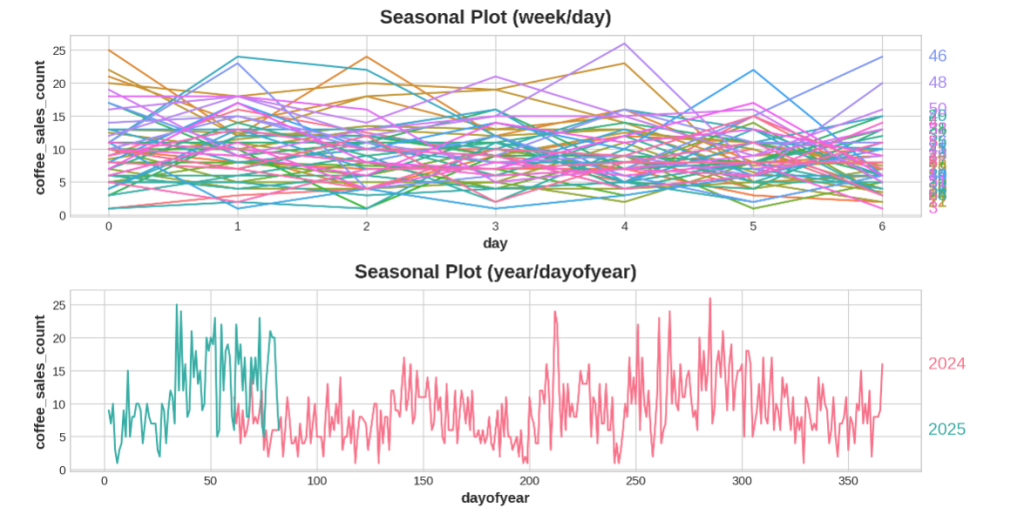
Assim como um plot da Média Móvel para descobrir a Tendência, utilizamos o Plot sazonal para descobrir a sazonalidade.

Fourier e Periodograma

A Feature Fourier tenta capturar a forma geral da curva sazonal, ao invés de tentar capturar para cada data.

Abaixo um gráfico de venda de café, podemos ver movimentos para cima e para baixo em alguns momentos do ano.

Essas frequências que tantamos visualizar com a Feature de Fourier. As curvas são das funções trigonométricas seno e cosseno.

São pares de curvas de seno e cosseno, um par para cada frequência potencial, iniciando pela mais longa. Os pares de Fourier que modelam a sazonalidade anual teriam frequências: uma vez por ano, duas vezes por ano, três vezes por ano e assim por diante.

site https://seara.ufc.br/pt/producoes/nossas-producoes-e-colaboracoes/secoes-especiais-de-ciencia-e-tecnologia/tintim-por-tintim/matematica/as-series-de-fourier/ – acesso 12 maio 2025.

Caracteristica de Fourier com o Periodograma

Quantos pares de Fourier devemos incluir como features. O periodograma pode ajudar a responder.

O periodograma é uma ferramenta da análise espectral e mostra quais frequências estão presentes em uma série temporal e com qual intensidade.

No Periodograma o eixo-y é: (a ** 2 + b ** 2) / 2 onde a e b são os coeficientes do seno e do cosseno naquela frequência.


Text Mining

Extrair informações importantes de textos, em .csv, banco de dados e de informação de grandes volumes textuais, análise de sentimentos, classificação de texto, detecção de fraudes e spam..

A maior parte são dados não estruturados, muita informação, com o Text Mining consegue-se extrair informações relevantes sobre todo esse volume de dados.

Onde pode ser utilizado?

Saúde e pesquisa.

Atendimento ao cliente.

Gestão de Riscos.

Pesquisa acadêmica.

Análise de sentimento.

Filtragem de Spam.

Pré-processamento

Tokenização: Transforma cada palavra ou frase em token

Stopwords: Utiliza somente as palavras importantes. Ex: “e”,”de,”um,”as”, …(português)

Lemmatization: Palavras importantes, aposto do stemming, precisão semantica, deixa a palavra no formato correto: ctz –> para –> certeza

lowercasing – minusculas

remover pontuação – se acaso não tiver valor semantico, se tiver valor semantico não remover.

stemming – reduz a palavra a sua raiz. Ex. fez, fazem, fazer –> para –> fazer.

Dica: iastudio.google.com – mostra quantos token com a pergunta e com a resposta (deixa mais barato a quantidade de token em um modelo generativo):

Exemplo de Libs:

NLTK – toolkit de NLP (https://www.nltk.org/)

wordcloud – https://www.wordclouds.com/

spacy – o que é verbo, o que é artigo… https://spacy.io/

Analise de sentimento:

Separar aspectos positivos e aspectos negativos.

Aspectos positivos: Ex: bom, sabor

Aspectos negativos: Ex: demora, ruim

Aspectos Neutros.

Desafios em NLP

Ambiguidade

A ambiguidade pode ser um desafio em NLP, palavras com mais de 1 sentido. Exemplo: Sonha, sonho dormindo e sonho de doce.

Sarcasmo e Ironia

“Seria ótimo se não fosse tão ruim”

NLP – Análise de Sentimento

TextBlob()

Polaridade:

-1 negativo, 0 neutro, 1 positivo, ou seja, quanto mais perto o valor da polaridade for de -1 mais tende ao negativo, o inverso tambem.

Subjetividade:

0 indica uma informação mais objetiva, baseada em fato.

1 baseada em opinião, subjetividade, não baseada em fato.

Outras bibliotecas mais detalhadas:

VANDER SentmentIntensityAnalyser()

  • pos:o quão positiva é a frase ou documento;
  • neu:o quão neutra é a frase ou documento;
  • neg:o quão é negativa;
  • compound:pontuação geral.

TF-IDC (frequencia do texto):

Avaliar a importância de 1 palavara, combinando a frequencia do termo.

Exemplo: a palavra “xxx” aparece 3 vezes no documento de 100 palavras: TF(xxx) = 3/100 = 0,03

IDF ():

O Quão rara é a palavra

Bag of Words (bow)

Palavras em números, converte palavras em numeros, a unica maneira de utilizar estatisticas, probabilidade no qual os modelos vai compreender.

Vai transformar cada frase em uma linha:

NLP, Text Mining, Sentiment Analysis

Processamento da Linguagem Natural:

Área da linguistica e aprendizado de maquina (ML) relacionado ao entendido de linguagem humana.

Objetivo do NLP

Classificação de sentimento, identificar spam, se tem verbo, substativo, preencher lacunas de textos, extrair respostats baseadas em uma pergunta passada, traduzir o texto para outro idioma.

Tambem engloba outros desafios, como visão computacional, geração da transcrição de áudio e descrição de imagem.

Deep Learning

Deep Learning é bom para previsão, mas dificil explicar o impacto das variáveis, muito complexo, principalmente para muitas camadas.

Não recomendado para explicação de fenômenos, pelo motivo acima, muita complexidade.

Estudo das Redes Neurais Artificiais de multiplas camadas.

Site: https://sites.icmc.usp.br/andre/research/neural/ – acesso 12 de março de 2025.

Percusores foi o modelo Perceptron (criado por Frank Rosenblatt em 1958) com um simples neuronio.

Site: https://www.deeplearningbook.com.br/o-perceptron-parte-1/ – acesso 12 de março de 2025.

Rede Neural Artificial:

Site: https://www.youtube.com/watch?v=mWD8wWwZpi8 – acesso 12 de março de 2025.

Como funciona:

Multiplicação de matrizes, com os pesos corretos, ótimo predict.

Função de Ativação:

Mais utilizada é a ReLu (classificação 1 ou 0):

Outra função de ativação bem conhecida é a sigmoide.

Função Custo:

Mostra o quanto errou a sua rede, exemplo de função de custo é o erro quadrático médio, mas existem muitas outras funções de custo.

Descida do Gradiente:

Encontrar o menor valor da função custo com base nos seus pesos. Esse método se chama Backpropagation.

Por trás é baseado em calculo diferencial.

*Empiricamente as Redes Neurais Artificiais aprendem melhor com dados Normalizados, como o método min-max normalization (valor fica entre 0 e 1), aprendem melhor com numeros “menores”, provavel devido a backpropagation. Intuitivamente se eu tiver valores muito grandes terei erros muito grandes e vou propagar ele durante a rede, a ideia de normalizar é ter uma descida de gradiente mais suave, e buscar o melhor valor do vale com menor função custo.

Ensemble

Modelo supervisionado

Classificação ou Preditivos

Tipos de Ensemble: Bagging / Boosting / Stacking

Bagging: A ideia e ter varios modelos e escolher a media, aquela mais votada e escolhe ela.

Bosting: sempre tentando melhorar o erro do modelo anterior

Stacking: Com a saida coloca como entrada do modelo, bastante utilizado quando as empresas compram modelos de terceiros (ex. do Serasa)

Árvores de decisão

Principais caracteristicas:

  • Algoritmos suscetível a “overfitting”, por isso é recomendável realizar validação cruzada (“cross validation”).
  • Achar o tamanho “ideal” da árvore para assim diminuir sua complexidade e dimunuir também o overfitting, ao mesmo tempo maximizando a qualidade do modelo.
  • Variável resposta quantitativa e qualitativa

Visualmente parece uma árvore com uma cascata de perguntas e probabilidade, cada pergunta é uma quebra, a ultima pergunta é a folha, e a quantidade de perguntas é a profundidade da árvore.

Impurezas: o algoritmo busca minimizar o indicador de “impureza”, testa todas as possíveis quebras binárias com todas as variáveis disponíveis. Com menor impureza. Até um critério de parada, até impureza zero por exemplo, ou só faço mais quebra se tiver 30 sobreviventes no caso do titanic sobreviventes.

Exemplo de 2 tipos para definição de impureza: (como a árvore encontra a melhor quebra)

  • Gini
  • Entropia de Shannon

Hiperparâmetros: são parâmetros que controlam o algoritmo como:

  • Número mínimo de observações por folha
  • Profundidade máxima
  • CP – Custo de complexidade

CP – Custo da complexidade, deixar a arvore mais generica.

Em uma árvore para cada ponto de corte Curva-ROC tenho uma nova matrix confusão, consequentemente uma nova sensitividade e especificidade, Curva-ROC.