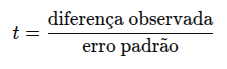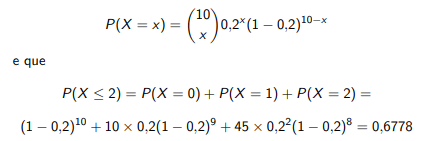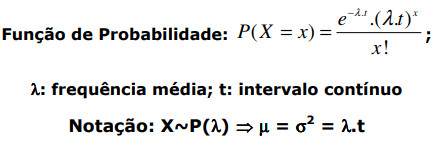Métodos de Agregação de Síntese – AHP Gaussiano

O AHP Gaussiano (Analytic Hierarchy Process Gaussiano):

O método AHP Gaussiano é a evolução do método AHP (Analytic Hierarchy Process), ele utiliza uma abordagem estatística baseada na variabilidade dos dados (desvio padrão e coeficiente de variação).

Fórmula:

Exemplo: Critérios de decisão, em algum momento você ganha e inicio a perda.

Sim. Um exemplo bastante didático para o blog seria a seleção de fornecedores, pois permite demonstrar critérios de maximização e minimização.

Limitações do AHP-Gaussiano

O artigo sobre aplicação do método em sensores inteligentes destaca duas limitações principais. researchgate.net

O AHP tradicional é geralmente recomendado para hierarquias com aproximadamente sete elementos, admitindo-se uma variação de dois elementos, devido ao esforço cognitivo exigido pelas comparações par a par. O AHP-Gaussiano reduz essa limitação, pois calcula os pesos a partir da dispersão dos dados quantitativos. Entretanto, exige critérios independentes, dados positivos e representativos e uma quantidade suficiente de alternativas para que as medidas de dispersão sejam confiáveis.

1. Não admite diretamente valores negativos

A formulação trabalha com razões, médias e coeficientes de variação. Por isso, critérios com valores negativos podem produzir resultados inadequados ou incompatíveis com os pressupostos do método.

Isso pode acontecer, por exemplo, com:

  • lucros e prejuízos;
  • variações percentuais negativas;
  • temperaturas abaixo de zero;
  • escalas centradas em zero.

Nesses casos, é necessário transformar justificadamente a escala ou escolher outro método multicritério.

2. É essencialmente quantitativo

O AHP-Gaussiano calcula os pesos a partir dos valores existentes na matriz de decisão. Assim, critérios qualitativos, como conforto, design ou facilidade de manutenção, não entram diretamente.

Eles podem ser transformados em escalas numéricas, mas essa conversão exige cuidado. Uma codificação inadequada pode introduzir subjetividade e favorecer artificialmente uma alternativa. researchgate.net

Outras limitações e cuidados importantes

  • Critérios independentes: o método pressupõe que os critérios não estejam medindo praticamente a mesma coisa. Utilizar “consumo”, “economia de combustível” e “custo mensal de combustível”, por exemplo, pode contar a mesma informação várias vezes. A proposta original chegou a incorporar a correlação de Pearson para verificar relações entre critérios. journals.sagepub.com
  • Método compensatório: um desempenho muito bom pode compensar um desempenho muito ruim. Um carro barato e econômico poderia subir no ranking mesmo apresentando um resultado considerado inaceitável em segurança. Se houver limites obrigatórios, eles devem ser aplicados antes do AHP-Gaussiano.
  • Peso determinado pela dispersão: o método não pergunta ao decisor qual critério é mais importante. Um critério recebe maior peso quando diferencia mais as alternativas. Assim, grande variação não significa automaticamente grande importância estratégica.
  • Sensibilidade a valores extremos: um carro com valor muito diferente dos demais pode aumentar o desvio-padrão e, consequentemente, o peso do critério. Estudos recentes também apontam sensibilidade à distribuição, a valores discrepantes e a vieses na coleta dos dados. nature.com
  • Dependência da qualidade dos dados: erros, dados ausentes, períodos de medição diferentes ou fontes pouco confiáveis afetam diretamente os pesos e o ranking.
  • Instabilidade com poucas alternativas: matematicamente é possível calcular o método com duas alternativas, mas o desvio-padrão ficará determinado apenas pela diferença entre elas. Com tão poucos valores, a ideia de uma dispersão associada a uma distribuição gaussiana se torna estatisticamente frágil.
  • Mudança do conjunto de alternativas: ao adicionar ou remover um carro, mudam a normalização, a média, o desvio-padrão, os pesos e possivelmente o ranking.

Exemplo: escolha de fornecedor com AHP-Gaussiano

Uma empresa precisa selecionar um fornecedor de componentes. Quatro empresas apresentaram propostas, mas nenhuma é claramente superior em todos os critérios.

Alternativas

  • Fornecedor A
  • Fornecedor B
  • Fornecedor C
  • Fornecedor D

Matriz de decisão

FornecedorCusto unitário (R$) ↓Prazo de entrega (dias) ↓Taxa de defeitos (%) ↓Capacidade mensal ↑Entregas no prazo (%) ↑
A5251,89.00096
B4783,212.00090
C5541,27.50098
D4962,010.50094
  • ↓ quanto menor, melhor: custo, prazo e defeitos;
  • ↑ quanto maior, melhor: capacidade e entregas no prazo.

Neste exemplo:

  • (m=4) alternativas;
  • (n=5) critérios.

Por que não escolher antecipadamente?

O fornecedor B possui o menor custo e a maior capacidade, mas apresenta o maior prazo e a maior taxa de defeitos.

O fornecedor C tem a menor taxa de defeitos, o menor prazo e o melhor percentual de entregas no prazo, porém possui o maior custo e a menor capacidade.

Portanto, não podemos dizer antecipadamente qual é o melhor. É necessário agregar todos os critérios.

Etapas

  1. Construir a matriz de decisão.
  2. Identificar critérios de maximização e minimização.
  3. Converter os critérios para a mesma direção de preferência.
  4. Normalizar a matriz.
  5. Calcular a média de cada critério.
  6. Calcular o desvio-padrão.
  7. Calcular o fator gaussiano.
  8. Normalizar os fatores gaussianos.
  9. Multiplicar a matriz normalizada pelo vetor de pesos.
  10. Obter o índice de preferência global e o ranking.

A matriz de decisão é:
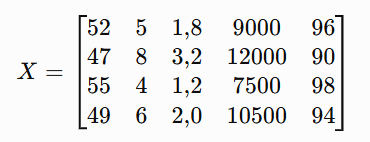
De forma geral:

X=[x11x12⋯x1nx21x22⋯x2n⋮⋮⋱⋮xm1xm2⋯xmn]X= \begin{bmatrix} x_{11} & x_{12} & \cdots & x_{1n}\\ x_{21} & x_{22} & \cdots & x_{2n}\\ \vdots & \vdots & \ddots & \vdots\\ x_{m1} & x_{m2} & \cdots & x_{mn} \end{bmatrix}

A direção dos critérios é:

  • custo unitário: quanto menor, melhor;
  • prazo de entrega: quanto menor, melhor;
  • taxa de defeitos: quanto menor, melhor;
  • capacidade mensal: quanto maior, melhor;
  • entregas no prazo: quanto maior, melhor.

2. Tratamento da direção dos critérios

Antes da normalização, todos os critérios precisam estar orientados na mesma direção. Neste exemplo, valores maiores deverão sempre representar desempenhos mais favoráveis.

Para os critérios de benefício, o valor original será mantido. Para os critérios de custo, será utilizada a transformação recíproca:

yij={xij,se o critério j for de benefício1xij,se o critério j for de custoy_{ij}= \begin{cases} x_{ij}, & \text{se o critério } j \text{ for de benefício}\\[6pt] \dfrac{1}{x_{ij}}, & \text{se o critério } j \text{ for de custo} \end{cases}

Assim, para um critério de custo:

yij=1xijy_{ij}=\frac{1}{x_{ij}}

Por exemplo, para o custo unitário do fornecedor A:

yA,custo=152=0,019231y_{A,\text{custo}} = \frac{1}{52} = 0{,}019231

Para o fornecedor B:

yB,custo=147=0,021277y_{B,\text{custo}} = \frac{1}{47} = 0{,}021277

Como o fornecedor B possui o menor custo, ele passa a apresentar o maior valor transformado nesse critério.

Após a transformação dos critérios de minimização, obtém-se:

FornecedorCustoPrazoDefeitosCapacidadeEntregas no prazo
A0,0192310,2000000,5555569.00096
B0,0212770,1250000,31250012.00090
C0,0181820,2500000,8333337.50098
D0,0204080,1666670,50000010.50094

3. Normalização da matriz de decisão

A normalização converte os critérios para uma escala comparável. Cada valor tratado é dividido pela soma de sua coluna:

rij=yij∑k=1mykjr_{ij} = \frac{y_{ij}} {\displaystyle\sum_{k=1}^{m}y_{kj}}

Para um critério de benefício, a expressão pode ser escrita como:

rij=xij∑k=1mxkjr_{ij} = \frac{x_{ij}} {\displaystyle\sum_{k=1}^{m}x_{kj}}

Para um critério de custo tratado pela transformação recíproca:

rij=1xij∑k=1m1xkjr_{ij} = \frac{\dfrac{1}{x_{ij}}} {\displaystyle\sum_{k=1}^{m}\dfrac{1}{x_{kj}}}

Exemplo para a capacidade do fornecedor A

A soma das capacidades é:

∑i=14xi,capacidade=9000+12000+7500+10500=39000\sum_{i=1}^{4}x_{i,\text{capacidade}} = 9000+12000+7500+10500 = 39000

Logo, a capacidade normalizada do fornecedor A é:

rA,capacidade=900039000=0,2308r_{A,\text{capacidade}} = \frac{9000}{39000} = 0{,}2308

A matriz normalizada resultante é:

FornecedorCustoPrazoDefeitosCapacidadeEntregas no prazo
A0,24310,26970,25240,23080,2540
B0,26900,16850,14200,30770,2381
C0,22990,33710,37850,19230,2593
D0,25800,22470,22710,26920,2487
Soma1,00001,00001,00001,00001,0000

Depois da normalização, a soma das alternativas em cada critério é igual a 1:

∑i=1mrij=1\sum_{i=1}^{m}r_{ij}=1

4. Transposição da matriz normalizada

Na matriz transposta, cada linha passa a representar um critério e cada coluna passa a representar uma alternativa:

RT=[r11r21⋯rm1r12r22⋯rm2⋮⋮⋱⋮r1nr2n⋯rmn]R^{T}= \begin{bmatrix} r_{11} & r_{21} & \cdots & r_{m1}\\ r_{12} & r_{22} & \cdots & r_{m2}\\ \vdots & \vdots & \ddots & \vdots\\ r_{1n} & r_{2n} & \cdots & r_{mn} \end{bmatrix}

No exemplo:

CritérioFornecedor AFornecedor BFornecedor CFornecedor D
Custo0,24310,26900,22990,2580
Prazo0,26970,16850,33710,2247
Defeitos0,25240,14200,37850,2271
Capacidade0,23080,30770,19230,2692
Entregas no prazo0,25400,23810,25930,2487

A transposição não altera os valores. Ela apenas facilita a realização dos cálculos estatísticos por critério.

5. Cálculo da média

A média das alternativas em cada critério é calculada por:

μj=∑i=1mrijm\mu_j = \frac{\displaystyle\sum_{i=1}^{m}r_{ij}}{m}

Como a soma de cada critério normalizado é igual a 1:

μj=1m\mu_j=\frac{1}{m}

Neste exemplo, existem quatro fornecedores:

μj=14=0,25\mu_j = \frac{1}{4} = 0{,}25

onsequentemente, todos os critérios apresentam a mesma média após a normalização:

CritérioMédia
Custo0,2500
Prazo0,2500
Defeitos0,2500
Capacidade0,2500
Entregas no prazo0,2500

6. Cálculo do desvio-padrão

O desvio-padrão mostra o quanto os fornecedores se diferenciam em cada critério. Neste exemplo, será utilizado o desvio-padrão amostral:

σj=∑i=1m(rij−μj)2m−1\sigma_j = \sqrt{ \frac{ \displaystyle\sum_{i=1}^{m} \left(r_{ij}-\mu_j\right)^2 }{m-1} }

Para o critério custo:

σcusto=(0,2431−0,25)2+(0,2690−0,25)2+(0,2299−0,25)2+(0,2580−0,25)24−1\sigma_{\text{custo}} = \sqrt{ \frac{ (0{,}2431-0{,}25)^2+ (0{,}2690-0{,}25)^2+ (0{,}2299-0{,}25)^2+ (0{,}2580-0{,}25)^2 }{4-1} }
σcusto≈0,0171\sigma_{\text{custo}} \approx 0{,}0171

Os resultados para todos os critérios são:

CritérioMédia Desvio-padrão
Custo0,25000,0171
Prazo0,25000,0713
Defeitos0,25000,0979
Capacidade0,25000,0497
Entregas no prazo0,25000,0090

A taxa de defeitos apresentou o maior desvio-padrão, indicando maior diferença entre os fornecedores. O percentual de entregas no prazo apresentou o menor desvio, pois os valores das alternativas são relativamente próximos.

7. Cálculo do fator gaussiano

O fator gaussiano corresponde ao coeficiente de variação do critério:

Gj=σjμjG_j = \frac{\sigma_j}{\mu_j}

Para o custo:

Gcusto=0,01710,25=0,0684G_{\text{custo}} = \frac{0{,}0171}{0{,}25} = 0{,}0684

Os fatores gaussianos obtidos são:

CritérioMédiaDesvio-padrãoFator gaussiano
Custo0,25000,01710,0684
Prazo0,25000,07130,2851
Defeitos0,25000,09790,3914
Capacidade0,25000,04970,1986
Entregas no prazo0,25000,00900,0361

Quanto maior o fator gaussiano, maior é a dispersão relativa dos desempenhos das alternativas naquele critério. Consequentemente, maior será sua capacidade de diferenciar os fornecedores.

Isso não significa necessariamente que o critério seja mais importante do ponto de vista estratégico. Significa que ele apresentou maior variabilidade nos dados utilizados.

A soma dos fatores gaussianos é:

Gtotal=∑j=1nGjG_{\text{total}} = \sum_{j=1}^{n}G_j

No exemplo:

∑j=15Gj=0,0684+0,2851+0,3914+0,1986+0,0361\sum_{j=1}^{5}G_j = 0{,}0684+ 0{,}2851+ 0{,}3914+ 0{,}1986+ 0{,}0361
∑j=15Gj≈0,9797\sum_{j=1}^{5}G_j \approx 0{,}9797

Os fatores gaussianos ainda não correspondem aos pesos finais, pois precisam ser normalizados.

8. Normalização dos fatores gaussianos

O peso normalizado de cada critério é calculado por:

wj=Gj∑k=1nGkw_j = \frac{G_j} {\displaystyle\sum_{k=1}^{n}G_k}

Para o critério custo:

wcusto=0,06840,9797=0,0698w_{\text{custo}} = \frac{0{,}0684}{0{,}9797} = 0{,}0698

Convertendo para porcentagem:

wcusto(%)=0,0698×100=6,98%w_{\text{custo}}(\%) = 0{,}0698\times100 = 6{,}98\%

Os pesos normalizados são:

CritérioFator G_jPeso w_jPeso percentual
Custo0,06840,06986,98%
Prazo0,28510,291029,10%
Defeitos0,39140,399539,95%
Capacidade0,19860,202720,27%
Entregas no prazo0,03610,03693,69%
Total0,97971,0000100%

Depois da normalização:

∑j=1nwj=1\sum_{j=1}^{n}w_j=1

Ou, em porcentagem:

∑j=1nwj=100%\sum_{j=1}^{n}w_j=100\%

A taxa de defeitos recebeu o maior peso, com 39,95%, seguida pelo prazo, com 29,10%. Esses critérios apresentaram as maiores dispersões relativas entre os fornecedores.

O vetor de pesos é:

𝐰=[0,06980,29100,39950,20270,0369]\mathbf{w} = \begin{bmatrix} 0{,}0698\\ 0{,}2910\\ 0{,}3995\\ 0{,}2027\\ 0{,}0369 \end{bmatrix}

9. Cálculo do índice de preferência global

A etapa final consiste em agregar o desempenho das alternativas em todos os critérios. A pontuação da alternativa i é calculada por:

Si=∑j=1nrijwjS_i = \sum_{j=1}^{n}r_{ij}w_j

Na forma matricial:

𝐒=𝐑𝐰\mathbf{S} = \mathbf{R}\mathbf{w}

De maneira expandida:

[S1S2⋮Sm]=[r11r12⋯r1nr21r22⋯r2n⋮⋮⋱⋮rm1rm2⋯rmn][w1w2⋮wn]\begin{bmatrix} S_1\\ S_2\\ \vdots\\ S_m \end{bmatrix} = \begin{bmatrix} r_{11} & r_{12} & \cdots & r_{1n}\\ r_{21} & r_{22} & \cdots & r_{2n}\\ \vdots & \vdots & \ddots & \vdots\\ r_{m1} & r_{m2} & \cdots & r_{mn} \end{bmatrix} \begin{bmatrix} w_1\\ w_2\\ \vdots\\ w_n \end{bmatrix}

Fornecedor A

SA=(0,2431×0,0698)+(0,2697×0,2910)+(0,2524×0,3995)+(0,2308×0,2027)+(0,2540×0,0369)\begin{aligned} S_A={}& (0{,}2431\times0{,}0698) +(0{,}2697\times0{,}2910)\\ &+(0{,}2524\times0{,}3995) +(0{,}2308\times0{,}2027)\\ &+(0{,}2540\times0{,}0369) \end{aligned}
SA≈0,2524S_A\approx0{,}2524

Fornecedor B

SB=(0,2690×0,0698)+(0,1685×0,2910)+(0,1420×0,3995)+(0,3077×0,2027)+(0,2381×0,0369)\begin{aligned} S_B={}& (0{,}2690\times0{,}0698) +(0{,}1685\times0{,}2910)\\ &+(0{,}1420\times0{,}3995) +(0{,}3077\times0{,}2027)\\ &+(0{,}2381\times0{,}0369) \end{aligned}
SB≈0,1957S_B\approx0{,}1957

Fornecedor C

SC=(0,2299×0,0698)+(0,3371×0,2910)+(0,3785×0,3995)+(0,1923×0,2027)+(0,2593×0,0369)\begin{aligned} S_C={}& (0{,}2299\times0{,}0698) +(0{,}3371\times0{,}2910)\\ &+(0{,}3785\times0{,}3995) +(0{,}1923\times0{,}2027)\\ &+(0{,}2593\times0{,}0369) \end{aligned}
SC≈0,3139S_C\approx0{,}3139

Fornecedor D

SD=(0,2580×0,0698)+(0,2247×0,2910)+(0,2271×0,3995)+(0,2692×0,2027)+(0,2487×0,0369)\begin{aligned} S_D={}& (0{,}2580\times0{,}0698) +(0{,}2247\times0{,}2910)\\ &+(0{,}2271\times0{,}3995) +(0{,}2692\times0{,}2027)\\ &+(0{,}2487\times0{,}0369) \end{aligned}
SD≈0,2379S_D\approx0{,}2379

O vetor resultante é:

𝐒=[0,25240,19570,31390,2379]\mathbf{S} = \begin{bmatrix} 0{,}2524\\ 0{,}1957\\ 0{,}3139\\ 0{,}2379 \end{bmatrix}

A soma dos índices de preferência é igual a 1:

∑i=1mSi=1\sum_{i=1}^{m}S_i=1

10. Ranking final

AlternativaÍndice de preferênciaPercentualRanking
Fornecedor C0,313931,39%1º
Fornecedor A0,252425,24%2º
Fornecedor D0,237923,79%3º
Fornecedor B0,195719,57%4º
Total1,0000100%

A melhor alternativa é aquela que maximiza o índice de preferência:

i∗=arg max⁡iSii^{*} = \underset{i}{\operatorname{arg\,max}}\;S_i

Neste exemplo:

SC=0,3139=31,39%S_C = 0{,}3139 = 31{,}39\%

E a ordenação final é:

SC>SA>SD>SBS_C>S_A>S_D>S_B

Portanto:

Fornecedor C — 1º lugar\boxed{\text{Fornecedor C — 1º lugar}}

Resultados

O fornecedor C foi a alternativa recomendada pelo AHP-Gaussiano. Embora tenha apresentado o maior custo e a menor capacidade mensal, obteve os melhores desempenhos no prazo de entrega e na taxa de defeitos, justamente os critérios que receberam os maiores pesos.

O fornecedor B, mesmo possuindo o menor custo e a maior capacidade, ficou na última posição porque apresentou o maior prazo e a maior taxa de defeitos.

O resultado mostra que a escolha não depende de uma única variável. O AHP-Gaussiano agregou todos os critérios, considerando tanto o desempenho normalizado dos fornecedores quanto a capacidade de cada critério de diferenciá-los.

Conclusão

Considerando exclusivamente os fornecedores, critérios e dados utilizados neste exemplo, o fornecedor C apresentou o maior índice de preferência global e foi a alternativa recomendada pelo AHP-Gaussiano.

Essa conclusão não significa que o fornecedor C seja universalmente o melhor. O resultado é condicionado à matriz de decisão analisada. Alterações nos fornecedores, nos critérios ou nos dados podem modificar os pesos e o ranking final.

Também é importante observar que o método atribui maior peso aos critérios com maior dispersão relativa. Portanto, um critério recebe maior influência por diferenciar mais as alternativas, e não necessariamente porque tenha sido considerado estrategicamente mais importante pela empresa.

Antes da aplicação em uma decisão real, recomenda-se verificar a qualidade dos dados, possíveis correlações entre os critérios, valores extremos e a estabilidade do ranking por meio de uma análise de sensibilidade.
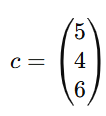
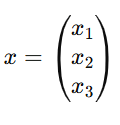
Otimização Linear – Problema da Mistura

Em busca da mistura com menos custo, ou seja, minimizar o preço.

Notação matemática:

A variável de decisão xj é a quantidade do ingrediente j.xamp;=(x1,x2,…,xn)T\begin{aligned} \text{A variável de decisão } x_j \text{ é a quantidade do ingrediente } j. \\ x &= (x_1, x_2, \dots, x_n)^T \end{aligned}
O ingrediente j tem custo Cj.camp;=(C1,C2,…,Cn)T\begin{aligned} \text{O ingrediente } j \text{ tem custo } C_j. \\ c &= (C_1, C_2, \dots, C_n)^T \end{aligned}
Cada ingrediente j possui proporção Aij do componente i.Aamp;=(A11amp;A12amp;…amp;A1nA21amp;A22amp;…amp;A2n⋮amp;⋮amp;⋱amp;⋮Am1amp;Am2amp;…amp;Amn)\begin{aligned} \text{Cada ingrediente } j \text{ possui proporção } A_{ij} \text{ do componente } i. \\ A &= \begin{pmatrix} A_{11} & A_{12} & \dots & A_{1n} \\ A_{21} & A_{22} & \dots & A_{2n} \\ \vdots & \vdots & \ddots & \vdots \\ A_{m1} & A_{m2} & \dots & A_{mn} \end{pmatrix} \end{aligned}
Cada componente i possui limite mínimo Ri e máximo Si.Ramp;=(R1,R2,…,Rm)TSamp;=(S1,S2,…,Sm)T\begin{aligned} \text{Cada componente } i \text{ possui limite mínimo } R_i \text{ e máximo } S_i. \\ R &= (R_1, R_2, \dots, R_m)^T \\ S &= (S_1, S_2, \dots, S_m)^T \end{aligned}
  • objetivo é achar as proporções dos ingredientes que respeitem os limites e chegue ao menor custo.
Objetivo: encontrar as proporções x que minimizam o customin⁡amp;cTxsujeito aamp;R≤Ax≤Samp;x≥0\begin{aligned} \text{Objetivo: encontrar as proporções } x \text{ que minimizam o custo} \\ \min \quad & c^T x \\ \text{sujeito a} \quad & R \leq A x \leq S \\ & x \geq 0 \end{aligned}

Modelo:

min⁡amp;c1x1+c2x2+⋯+cnxns.a:amp;x1+x2+⋯+xn=1amp;a1,1x1+a1,2x2+⋯+a1,nxn≥r1amp;a2,1x1+a2,2x2+⋯+a2,nxn≥r2amp;⋮amp;am,1x1+am,2x2+⋯+am,nxn≥rmamp;a1,1x1+a1,2x2+⋯+a1,nxn≤s1amp;a2,1x1+a2,2x2+⋯+a2,nxn≤s2amp;⋮amp;am,1x1+am,2x2+⋯+am,nxn≤smamp;x1,x2,…,xn≥0\begin{aligned} \min \quad & c_1 x_1 + c_2 x_2 + \dots + c_n x_n \\[6pt] \text{s.a:} \quad & x_1 + x_2 + \dots + x_n = 1 \\[6pt] & a_{1,1}x_1 + a_{1,2}x_2 + \dots + a_{1,n}x_n \ge r_1 \\ & a_{2,1}x_1 + a_{2,2}x_2 + \dots + a_{2,n}x_n \ge r_2 \\ & \vdots \\ & a_{m,1}x_1 + a_{m,2}x_2 + \dots + a_{m,n}x_n \ge r_m \\[6pt] & a_{1,1}x_1 + a_{1,2}x_2 + \dots + a_{1,n}x_n \le s_1 \\ & a_{2,1}x_1 + a_{2,2}x_2 + \dots + a_{2,n}x_n \le s_2 \\ & \vdots \\ & a_{m,1}x_1 + a_{m,2}x_2 + \dots + a_{m,n}x_n \le s_m \\[6pt] & x_1, x_2, \dots, x_n \ge 0 \end{aligned}

Exemplos de aplicações:

Exemplo 1)

Modelo: Alocação de Entregas com Capacidade

Contexto

Uma organização precisa distribuir entregas para centros regionais.
Cada centro deve ser atendido por exatamente um veículo.
Cada veículo tem um limite máximo de atendimentos.

O objetivo é minimizar a distância total percorrida.

from pulp import LpProblem, LpMinimize, LpVariable, lpSum, LpStatus, value, PULP_CBC_CMD
# Criar problema
modelo = LpProblem("Delivery_Allocation_Model", LpMinimize)
veiculos = ['V1', 'V2', 'V3']
locais = ['Norte', 'Sul', 'Leste', 'Oeste', 'Centro']
# Variável binária: y[v,l] = 1 se veículo v atende local l
y = LpVariable.dicts(
"assign",
[(v, l) for v in veiculos for l in locais],
cat="Binary"
)
# Matriz de custos (distâncias)
custo = {
('V1', 'Norte'): 15, ('V1', 'Sul'): 20,
('V1', 'Leste'): 10, ('V1', 'Oeste'): 25,
('V1', 'Centro'): 5,
('V2', 'Norte'): 18, ('V2', 'Sul'): 15,
('V2', 'Leste'): 12, ('V2', 'Oeste'): 22,
('V2', 'Centro'): 8,
('V3', 'Norte'): 20, ('V3', 'Sul'): 25,
('V3', 'Leste'): 15, ('V3', 'Oeste'): 18,
('V3', 'Centro'): 10,
}
# -------------------------
# Função Objetivo
# -------------------------
modelo += lpSum(custo[(v, l)] * y[(v, l)] for v in veiculos for l in locais)
# -------------------------
# Restrição 1:
# Cada local deve ser atendido exatamente uma vez
# -------------------------
for l in locais:
modelo += lpSum(y[(v, l)] for v in veiculos) == 1
# -------------------------
# Restrição 2:
# Capacidade máxima de atendimentos por veículo
# -------------------------
limite_atendimentos = {'V1': 3, 'V2': 2, 'V3': 3}
for v in veiculos:
modelo += lpSum(y[(v, l)] for l in locais) <= limite_atendimentos[v]
# Resolver
modelo.solve(PULP_CBC_CMD(msg=False))
# Resultados
print("Status:", LpStatus[modelo.status])
print("Distância total mínima:", value(modelo.objective))
for v in veiculos:
atendimentos = [l for l in locais if value(y[(v, l)]) > 0.5]
print(f"{v} atende: {', '.join(atendimentos) if atendimentos else 'Nenhum'}")
Status: Optimal
Distância total mínima: 63.0
V1 atende: Norte, Leste, Centro
V2 atende: Sul
V3 atende: Oeste

Exemplo 2)

custo mínimo para 1Kg de ração com as restrições abaixo de quantidade mínima de proteína e sódio.

Modelo com valores respectivos para Frango/Osso/Trigo, com:

  • mistura total = 1 kg
  • proteína mínima
  • sódio máximo
  • x1,x2,x3≥0x_1, x_2, x_3 \ge 0x1​,x2​,x3​≥0

Atenção: os coeficientes como exemplo na tabela (proteína: 0.6/0.2/0.1 e sódio: 0.1/0.05/0.02; limites proteína ≥ 0.4 e sódio ≤ 0.08).

import numpy as np
from scipy.optimize import linprog
# -------------------------
# Variáveis de decisão
# x1 = kg Frango, x2 = kg Osso, x3 = kg Trigo
# -------------------------
# Função objetivo: minimizar custo
# min 5x1 + 4x2 + 6x3
c = np.array([5, 4, 6], dtype=float)
# Restrições do tipo A_ub @ x <= b_ub
# 1) Proteína mínima: 0.6x1 + 0.2x2 + 0.1x3 >= 0.4
# Convertemos para <= multiplicando por -1:
# -0.6x1 -0.2x2 -0.1x3 <= -0.4
# 2) Sódio máximo: 0.1x1 + 0.05x2 + 0.02x3 <= 0.08
A_ub = np.array([
[-0.6, -0.2, -0.1], # proteína (convertida)
[ 0.1, 0.05, 0.02], # sódio
], dtype=float)
b_ub = np.array([
-0.4, # proteína mínima
0.08, # sódio máximo
], dtype=float)
# Restrição de igualdade: x1 + x2 + x3 = 1 (mistura total)
A_eq = np.array([[1, 1, 1]], dtype=float)
b_eq = np.array([1], dtype=float)
# Limites (não negatividade): x1, x2, x3 >= 0
bounds = [(0, None), (0, None), (0, None)]
# Resolver
res = linprog(
c=c,
A_ub=A_ub, b_ub=b_ub,
A_eq=A_eq, b_eq=b_eq,
bounds=bounds,
method="highs"
)
# Resultados
if res.success:
x1, x2, x3 = res.x
print("✅ Solução ótima encontrada (custo mínimo)")
print(f"x1 (Frango) = {x1:.4f} kg")
print(f"x2 (Osso) = {x2:.4f} kg")
print(f"x3 (Trigo) = {x3:.4f} kg")
print(f"Custo mínimo = R$ {res.fun:.4f}")
# Checagem das restrições (opcional)
proteina = 0.6*x1 + 0.2*x2 + 0.1*x3
sodio = 0.1*x1 + 0.05*x2 + 0.02*x3
print("\n🔎 Checagem:")
print(f"Total = {x1 + x2 + x3:.4f} (deve ser 1)")
print(f"Proteína = {proteina:.4f} (>= 0.4)")
print(f"Sódio = {sodio:.4f} (<= 0.08)")
else:
print("❌ Não foi possível encontrar solução.")
print("Motivo:", res.message)
✅ Solução ótima encontrada (custo mínimo)
x1 (Frango) = 0.5000 kg
x2 (Osso) = 0.5000 kg
x3 (Trigo) = 0.0000 kg
Custo mínimo = R$ 4.5000
🔎 Checagem:
Total = 1.0000 (deve ser 1)
Proteína = 0.4000 (>= 0.4)
Sódio = 0.0750 (<= 0.08)

Otimização Linear – Problema da Ração

Um dos primeiros problemas utilizando Otimização Linear e métodos de pesquisa operacional.

Problema da Ração é um exemplo típico utilizado como exemplo para Otimização Linear.

Imagina que uma fabrica de ração tenha que produzir a ração animal com 3 ingredientes, como o frango, osso e trigo.

Onde abaixo teríamos um custo, apenas como exemplo, dos 3 ingredientes por Kg:

Preço R$/Kg: Frango = 5 , Osso = 4, Trigo = 6

Sendo assim as variáveis decisão serão a quantidade para cada ingrediente:

Quantidade Kg: Frango = x1, Osso = x2, Trigo = x3

  1. Função Objetivo: Queremos reduzir o custo total de cada ingrediente da ração. Portanto o custo será:

Min 𝑐𝑇𝑥′ =5×1​+4×2​+6×3​

Curiosidade: O resultado da expressão cTx′c to the cap T-th power x prime é um escalar obtido pela combinação linear das derivadas das componentes do vetor

xx, resultando em: cTx′=∑i=1ncixi′bold c raised to the bold cap T power bold x prime equals sum from bold i equals 1 to bold n of bold c sub bold i bold x sub bold i prime

e

2) Restrições:

Quantidade de cada ingrediente não pode ser negativa e que a produção de pelo menos 1Kg de ração.

x1 + x2+ x3 = 1 (Kg)

x1 > =0

x2 > =0

x3 > =0

NutrienteFrango (x₁)Osso (x₂)Trigo (x₃)Restrição
Proteína0.60.20.1≥ 0.4
Sódio0.10.050.02≤ 0.08
Preço Kg546= 1 kg

ou seja, restrições são:

Quantidade total:x1+x2+x3=1x_1 + x_2 + x_3 = 1

Proteína mínima:0.6x1+0.2x2+0.1x3≥0.40.6x_1 + 0.2x_2 + 0.1x_3 \ge 0.4

Sódio máximo:0.1x1+0.05x2+0.02x3≤0.080.1x_1 + 0.05x_2 + 0.02x_3 \le 0.08

Não negatividade:x1,x2,x3≥0x_1, x_2, x_3 \ge 0

Abaixo está a solução em Python com linprog, Otimização para custo mínimo a cada 1Kg de ração.

import numpy as np
from scipy.optimize import linprog
# -------------------------
# Variáveis de decisão
# x1 = kg Frango, x2 = kg Osso, x3 = kg Trigo
# -------------------------
# Função objetivo: minimizar custo
# min 5x1 + 4x2 + 6x3
c = np.array([5, 4, 6], dtype=float)
# Restrições do tipo A_ub @ x <= b_ub
# 1) Proteína mínima: 0.6x1 + 0.2x2 + 0.1x3 >= 0.4
# Convertemos para <= multiplicando por -1:
# -0.6x1 -0.2x2 -0.1x3 <= -0.4
# 2) Sódio máximo: 0.1x1 + 0.05x2 + 0.02x3 <= 0.08
A_ub = np.array([
[-0.6, -0.2, -0.1], # proteína (convertida)
[ 0.1, 0.05, 0.02], # sódio
], dtype=float)
b_ub = np.array([
-0.4, # proteína mínima
0.08, # sódio máximo
], dtype=float)
# Restrição de igualdade: x1 + x2 + x3 = 1 (mistura total)
A_eq = np.array([[1, 1, 1]], dtype=float)
b_eq = np.array([1], dtype=float)
# Limites (não negatividade): x1, x2, x3 >= 0
bounds = [(0, None), (0, None), (0, None)]
# Resolver
res = linprog(
c=c,
A_ub=A_ub, b_ub=b_ub,
A_eq=A_eq, b_eq=b_eq,
bounds=bounds,
method="highs"
)
# Resultados
if res.success:
x1, x2, x3 = res.x
print("✅ Solução ótima encontrada (custo mínimo)")
print(f"x1 (Frango) = {x1:.4f} kg")
print(f"x2 (Osso) = {x2:.4f} kg")
print(f"x3 (Trigo) = {x3:.4f} kg")
print(f"Custo mínimo = R$ {res.fun:.4f}")
# Checagem das restrições (opcional)
proteina = 0.6*x1 + 0.2*x2 + 0.1*x3
sodio = 0.1*x1 + 0.05*x2 + 0.02*x3
print("\n🔎 Checagem:")
print(f"Total = {x1 + x2 + x3:.4f} (deve ser 1)")
print(f"Proteína = {proteina:.4f} (>= 0.4)")
print(f"Sódio = {sodio:.4f} (<= 0.08)")
else:
print("❌ Não foi possível encontrar solução.")
print("Motivo:", res.message)
✅ Solução ótima encontrada (custo mínimo)
x1 (Frango) = 0.5000 kg
x2 (Osso)   = 0.5000 kg
x3 (Trigo)  = 0.0000 kg
Custo mínimo = R$ 4.5000

🔎 Checagem:
Total       = 1.0000 (deve ser 1)
Proteína    = 0.4000 (>= 0.4)
Sódio       = 0.0750 (<= 0.08)

Testes de Hipótese – 2

Será que nos dados da população as variáveis são relevantes para o modelo ou são mero fruto do acaso?

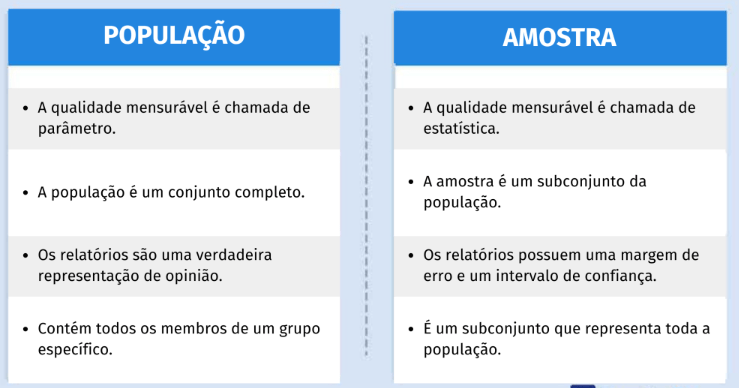
Parâmetros da população e Estatisticas da amostra.

site: https://www.questionpro.com/blog/pt-br/populacao-e-amostra/, acesso 26 setembro de 2025.

A variância influencia fortemente a significância.

1. Conceito de significância estatística

  • A significância vem de testes de hipótese.
  • Ela mede se um efeito observado (ex.: diferença entre médias, coeficiente de regressão, correlação) é provável de ter ocorrido por acaso ou se é um efeito consistente.
  • É expressa por meio do valor-p: quanto menor o valor-p, maior a evidência contra a hipótese nula (de “não efeito”).

2. Papel da variância

  • A variância dos dados afeta o erro padrão (desvio padrão da média ou do estimador).
  • Quanto maior a variância, maior a dispersão dos dados → maior o erro padrão → o teste estatístico perde poder → é mais difícil encontrar significância.
  • Quanto menor a variância, os dados ficam mais concentrados → menor o erro padrão → aumenta a chance de detectar um efeito como significativo (se ele existir).

Em fórmulas simplificadas, um teste t é:

E o erro padrão depende da variância:

Ou seja: se a variância (σ²) é alta, o erro é grande → t cai → p-valor aumenta → menor chance de significância.

O que são dados paramétricos?

São dados que seguem uma distribuição conhecida, geralmente a distribuição Normal (Gaussiana), ou que podem ser transformados para se aproximar dela (por exemplo, usando Box-Cox).

Quando dizemos que uma análise é paramétrica, significa que:

  • Faz suposições sobre os parâmetros da população (média, variância, etc.);
  • Assume que os dados vêm de uma distribuição específica (na maioria das vezes, normal);
  • Usa fórmulas matemáticas que dependem dessas premissas.

🔹 Exemplos de testes paramétricos

  • Teste t de Student (médias)
  • ANOVA (comparação de médias entre grupos)
  • Correlação de Pearson
  • Regressão linear

🔹 Características dos dados paramétricos

  1. Normalidade – os dados seguem (ou aproximadamente seguem) distribuição normal.
  2. Homocedasticidade – variâncias dos grupos comparados são iguais ou semelhantes.
  3. Independência – as observações não podem estar correlacionadas indevidamente.
  4. Escala intervalar ou de razão – precisam ser dados numéricos contínuos (ex.: altura, tempo, tamanho de banco de dados em GB).

🔹 Comparação com dados não paramétricos

  • Paramétricos: mais poderosos, mas exigem que os pressupostos sejam atendidos.
  • Não paramétricos: usados quando os dados não seguem normalidade ou não têm variâncias iguais (ex.: teste de Mann-Whitney, teste de Kruskal-Wallis).

Testes de Hipótese para dados Paramétricos (pressupõem normalidade dos dados):

OBS: para utilizar testes paramétricos , antes deve realizar teste de normalidade !!! (Ex. Shapiro-wilk-amostras pequenas < 30)

  • Teste para a média (com variância conhecida)
  • Teste para a média (com variância desconhecida)
  • Teste para a variância
  • Teste t pareado (comparação de médias em duas amostras dependentes)
  • Teste t independente (comparação de médias em duas amostras independentes)
  • ANOVA (comparação de médias em três ou mais grupos independentes)
  • Teste para comparação de variâncias

No quadro de decisão em testes de hipótese em formato de imagem, com destaque visual:

  • Erro Tipo I (α) em vermelho claro → rejeitar H₀ quando ela é verdadeira.
  • Erro Tipo II (β) em amarelo claro → não rejeitar H₀ quando ela é falsa.
  • As demais situações mostram as decisões corretas.

🚀 Passos para Realizar um Teste de Hipóteses

  1. Definir a variável em estudo
    • Identificar qual parâmetro será avaliado (média, variância, proporção etc.).
  2. Definir as hipóteses
    • Hipótese nula (H₀): não há efeito/diferença (hipótese padrão).
    • Hipótese alternativa (H₁): existe efeito/diferença.
  3. Escolher o nível de significância (α)
    • Probabilidade de cometer Erro Tipo I.
    • Valor comum: α = 0,05 (5%).
  4. Selecionar o teste estatístico
    • Depende do tipo de dado e do problema:
      • Teste z → variância conhecida e amostra grande.
      • Teste t → variância desconhecida ou amostra pequena.
      • ANOVA, Qui-quadrado, F de Snedecor, etc.
  5. Calcular a estatística de teste
    • Usar a fórmula do teste escolhido.
    • Comparar com valores críticos ou p-valor.

🧪 Testes de Hipótese para a Média Populacional:

Distribuição usada:

  • Se σ (variância populacional) é desconhecida → teste t de Student (mais comum).
  • Se σ é conhecida → pode-se usar o teste Z.

Para verificar se a média populacional μ é igual a um valor específico μ0​:


🔹 Teste bicaudal (duas caudas)

  • H₀: μ=μ0
  • H₁: μ≠μ0
    👉 Usado quando queremos detectar qualquer diferença (maior ou menor).

🔹 Teste unicaudal superior (uma cauda à direita)

  • H₀: μ=μ0
  • H₁: μ>μ0
    👉 Usado quando queremos verificar se a média é maior que μ0​.

🔹 Teste unicaudal inferior (uma cauda à esquerda)

  • H₀: μ=μ0
  • H₁: μ<μ0
    👉 Usado quando queremos verificar se a média é menor que μ0.

🧪 Teste para a Variância Populacional (qui-quadrado):

Ele é a versão análoga ao que vimos para a média, mas aqui usamos como estatística de teste a qui-quadrado .

Distribuição usada:

  • Porem assumimos que a média é conhecida e a variância que é desconhecida.

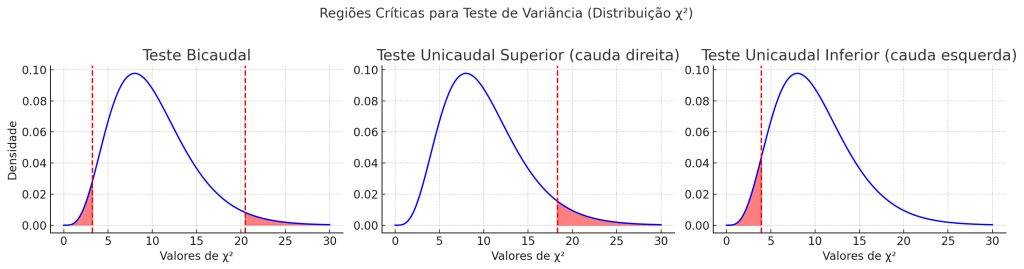
Seguem os gráficos das regiões críticas para o teste de variância usando a distribuição qui-quadrado:

Teste unicaudal inferior → rejeita H0 se χ2 cair na cauda esquerda.

Teste bicaudal → rejeita H0 se χ2 cair nas extremidades (caudas vermelhas).

Teste unicaudal superior → rejeita H0 se χ2 cair na cauda direita.

Resumo:

Teorema do Limite Central

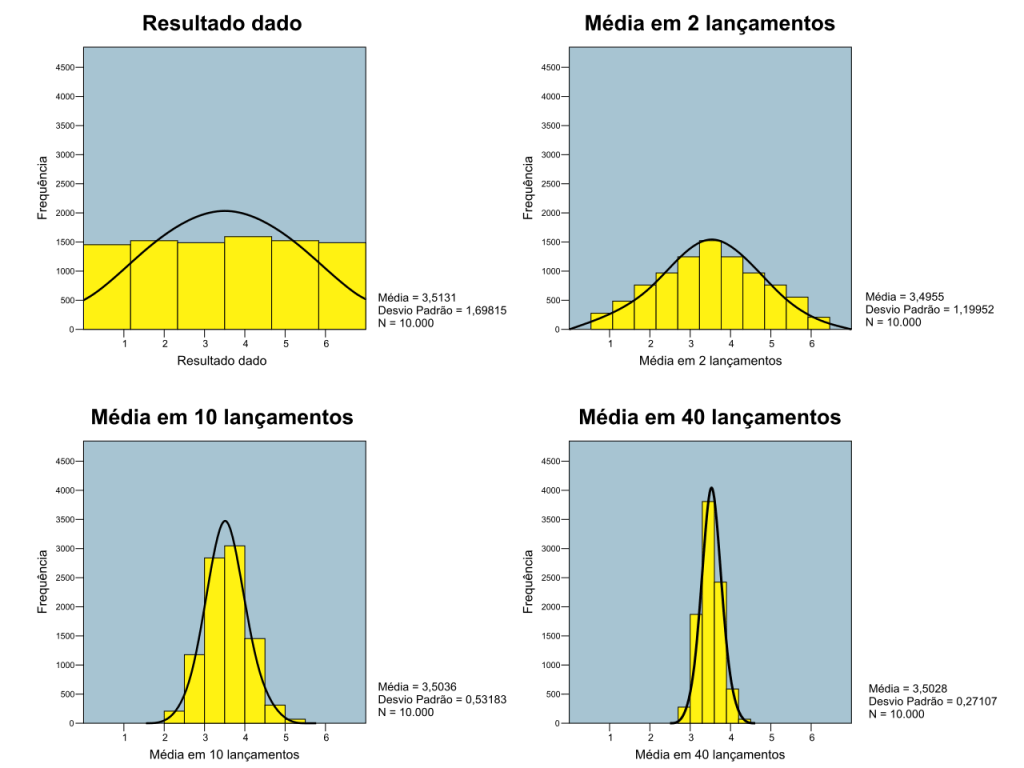
“O Teorema Central do Limite nos diz que conforme o tamanho da amostra aumenta, a distribuição amostral da média aproxima-se cada vez mais de uma distribuição normal. Portando a ideia é retirar várias amostras de uma mesma população, tomando a média de cada uma delas. A distribuição dessas médias é que tenderá a uma distribuição normal.” site: https://cursos.alura.com.br/forum/topico-teorema-do-limite-central-explicacao-148382, acesso 16 de setembro de 2025.

Principais Conceitos

  • Distribuição Amostral da Média: É a distribuição de todas as possíveis médias amostrais que podem ser obtidas ao tirar amostras de uma população. 
  • Independência e Distribuição Idêntica: As variáveis aleatórias devem ser independentes umas das outras e terem a mesma distribuição. 
  • Distribuição Normal: Uma distribuição de probabilidade simétrica em forma de sino, caracterizada por sua média e desvio padrão. 

Condições do Teorema 

  • O tamanho da amostra deve ser suficientemente grande. Geralmente, uma amostra com 30 ou mais observações é considerada adequada.
  • A população da qual as amostras são tiradas deve ter uma média e um desvio padrão bem definidos.

site: https://pt.wikipedia.org/wiki/Teorema_central_do_limite, acesso 17 setembro 2025.

Variáveis aleatórias bidimensionais

Variável aleatória conjunta de duas variáveis 𝑋1 e 𝑋2?
Queremos observar conjunto de par de variáveis (𝑋1,𝑋2)

número de “caras” na primeira e na segunda jogadas de uma moeda.

site: https://www.ime.usp.br/~yambar/MAE0219/Aula%209%20Modelos%20Bidimensionais%20I/Aula%209%20Bidimensionais%20I.pdf, acesso 17 setembro 2025.

Modelos probabilidade

Discretos

Bernoulli – 1 ou 0 (Ex. sim ou não ou sucesso ou não sucesso):

A probabilidade de X assumir um determinado valor x (0 ou 1) é dada por P(X = x) = px(1-p)1-x

Exemplo:

Um inspetor de qualidade extrai uma amostra aleatória de 10
tubos armazenados num depósito onde, de acordo com os padrões
de produção, se espera um total de 20% de tubos defeituosos.
Qual é a probabilidade de que não mais do que 2 tubos extraídos
sejam defeituosos?
Se X denotar a variável “número de tubos defeituosos em 10
extrações independentes e aleatórias”, qual o seu valor esperado?
Qual a variância?

Note que a variável aleatória X = número de tubos defeituosos em
10 extrações tem distribuição binomial, com parâmetros n = 10 e
p = 0,2. Portanto, “não mais do que dois tubos defeituosos” é o
evento {X ≤ 2}. Sabemos que, para X ∼ b(10 , 0,2)

Se X ∼ b(n, p), então
E(X) = np Var(X) = np(1 − p)
Basta então aplicar os valores fornecidos para vermos que o
n´umero esperado de tubos defeituosos num experimento com 10
extrações é de 2, e que a variância é de 1,6.

Binomial:

A distribuição binomial é usada para calcular a probabilidade de obter um certo número de “sucessos” em um número fixo de “tentativas” (ensaios de Bernoulli), onde cada tentativa tem apenas dois resultados possíveis e os resultados são independentes.

Fórmula:

  • n: O número total de tentativas.
  • k: O número de sucessos desejados.
  • p: A probabilidade de sucesso em uma única tentativa.
  • q (ou 1-p): A probabilidade de fracasso em uma única tentativa.

Como usar a fórmula:

A fórmula geral da distribuição binomial é: P(X=k) = C(n, k) * p^k * q^(n-k) 

Onde: 

  • P(X=k): A probabilidade de obter exatamente k sucessos.
  • C(n, k): O coeficiente binomial, que representa o número de combinações de escolher k sucessos em n tentativas.
  • p^k: A probabilidade de k sucessos.
  • q^(n-k): A probabilidade de (n-k) fracassos.

Poisson:

média e variância valores iguais.

Resumo:

A Distribuição de Bernoulli descreve o resultado de um único ensaio com dois resultados possíveis (sucesso ou fracasso); 

A Distribuição Binomial modela a soma de vários ensaios de Bernoulli independentes, contando o número de sucessos; 

A Distribuição de Poisson lida com a probabilidade de um certo número de eventos ocorrerem num intervalo fixo de tempo ou espaço, sendo útil para eventos raros.

Continuos

Uniforme: é um modelo de probabilidade onde cada resultado possível dentro de um determinado intervalo tem a mesma probabilidade de ocorrer.

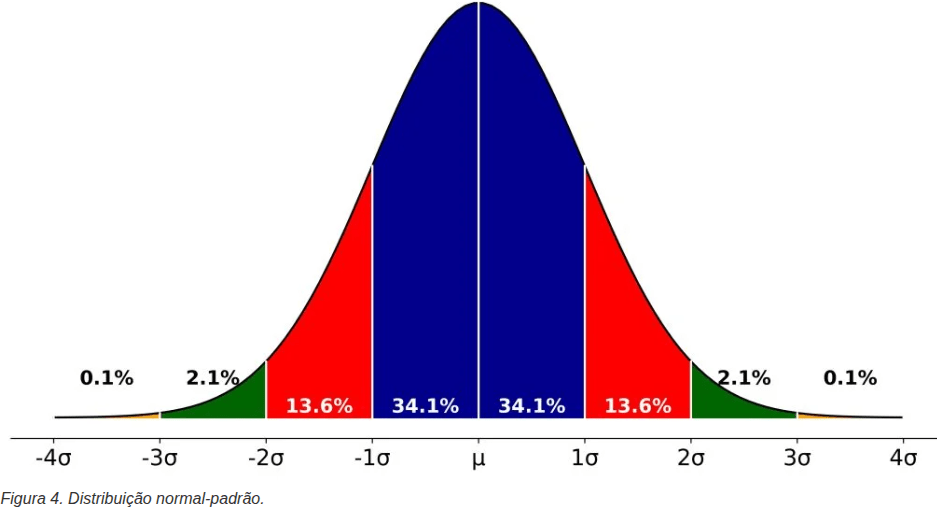
Distribuição normal: uma distribuição contínua e simétrica ao redor da média, a maioria dos valores tende a se agrupar ao redor da média e valores que se afastam da média (para mais ou para menos) tendem a ser menos frequentes.

site: https://www.blog.psicometriaonline.com.br/distribuicao-normal/, acesso 16 setembro 2025.

Normal padrão:uma distribuição normal teórica especial, cuja média é 0 e o desvio-padrão é 1.

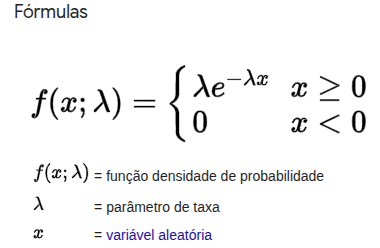
Exponencial:

É uma distribuição de probabilidade contínua que modela o tempo até a ocorrência de um evento em um processo de Poisson, ou seja, eventos que acontecem de forma independente e a uma taxa constante. Ela descreve a probabilidade de um evento ter uma duração ou ocorrer dentro de um certo tempo, sendo muito usada em áreas como análise de confiabilidade (tempo de vida de componentes) e tempos de espera. 

Exemplo: você quer saber a probabilidade de um aparelho eletrônico continuar funcionando após 3 anos, sabendo que, em média, ele dura 2 anos. A probabilidade de ele continuar funcionando diminui com o passar do tempo, o que é uma característica da distribuição exponencial. 

site: https://www.youtube.com/watch?v=87dvB9v1pRI, acesso 16 de setembro de 2025.

t-student

Parecida com a normal , mas com a cauda mais “pesada”, indicando uma maior probabilidade de ocorrerem valores extremos, mas aproxima-se da distribuição normal à medida que o número de graus de liberdade aumenta.

É uma distribuição de probabilidade em forma de sino, semelhante à distribuição normal, mas utilizada quando se trabalha com amostras pequenas ou com a variância populacional desconhecida.

  • Amostras pequenas: É a escolha ideal quando o tamanho da amostra é pequeno (geralmente inferior a 30 observações). 
  • Variância populacional desconhecida: Utiliza-se quando não se sabe o desvio padrão ou a variância da população. 

Qui-quadrado

é uma distribuição de probabilidade contínua usada em inferência estatística para testes de hipóteses, especialmente para avaliar se os dados observados se ajustam a uma distribuição esperada (teste de aderência) ou para testar a independência entre variáveis categóricas. Caracteriza-se por ser assimétrica à direita e definida por um parâmetro chamado graus de liberdade (k). 

F de Fisher-Snedecor

é uma distribuição de probabilidade de variáveis contínuas, definida como a razão de duas variáveis aleatórias independentes com distribuição qui-quadrado, divididas pelos seus respetivos graus de liberdade. É usada principalmente para inferência sobre a razão entre duas variâncias e em técnicas estatísticas como a Análise de Variância (ANOVA), onde compara a variabilidade entre grupos com a variabilidade dentro dos grupos. 

  • Assimetria: É uma distribuição assimétrica à direita, com valores que assumem apenas valores positivos. 
  • Graus de Liberdade: É caracterizada por dois parâmetros: os graus de liberdade do numerador e do denominador, que influenciam a forma da distribuição. 

pipeline()

Função pipeline()

Funcionamento:

Biblioteca função pipeline(), conecta os passos do seu modelo, exemplo abaixo:

Esse modelo utiliza um modelo pré-treinado e ajustado(fine-tuned) e analisa sentimentos dos textos em ingles.

Na função pipeline() exitem outras funcionalidades, como:

  • feature-extraction (pega a representação vetorial do texto)
  • fill-mask (preenchimento de máscara)
  • ner (reconhecimento de entidades nomeadas)
  • question-answering (responder perguntas)
  • sentiment-analysis (análise de sentimentos)
  • summarization (sumarização)
  • text-generation (geração de texto)
  • translation (tradução)
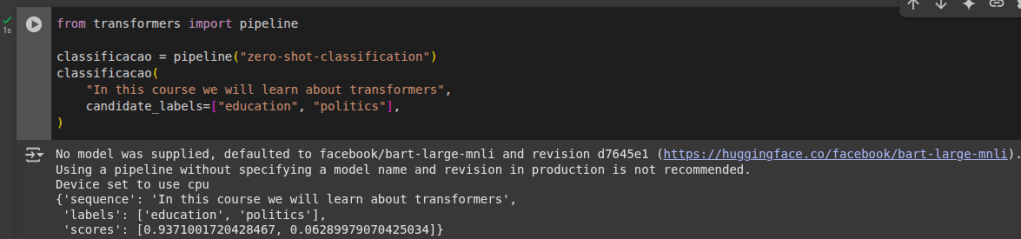
  • zero-shot-classification (classificação “zero-shot”)

Exemplo da função pipeline com zero-shot. Essa pipeline zero-shot você especifica quais rotulos deseja utilizar, escolhendo especificamento nos modelo já treinados, sem precisar fazer ajuste fino do modelo nos seus dados e já retorna os scores na lista de rótulos que você escolheu.

Text-generation (geração de texto):

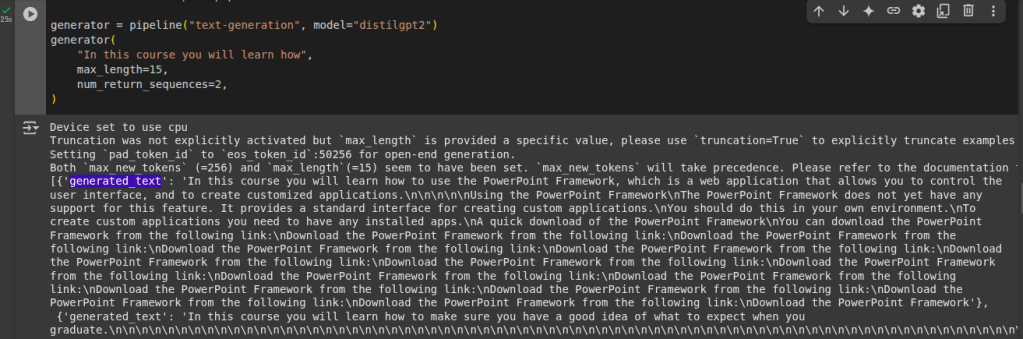
Nesse pipeline text-generation você passa um trecho de um texto e o modelo irá completar o restante.

Pode adicionar tambem os argumentos num_return_sequences (a quantidade de diferentes sequências são geradas) e o argumento max_length (tamanho máximo da saida-output).

Escolha de modelo no HuggingFace: https://huggingface.co/models

filtrar modelos por tarefas especificas:

Tarefas especificas e em outro idioma ou multi-lingual:

Fill-mask (preenchimento de máscara)

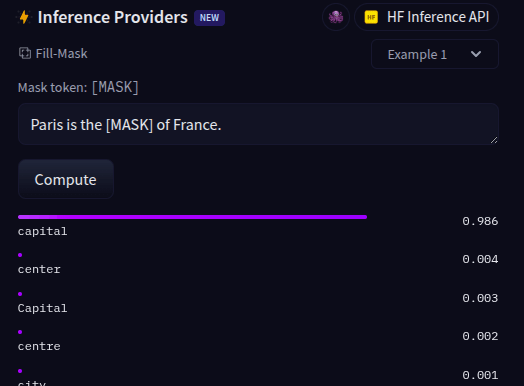
O pipeline mask-filling preenche algum espaço em branco por um texto:

OBS: a variavel <mask>, pode variar o modo como é chamada, exemplo no modelo bert é [MASK], verifique no modelo API antes https://huggingface.co/models?pipeline_tag=fill-mask&sort=trending

Exemplo em portugues:

NER (Reconhecimento de Entidades Nomeadas)

Reconhece as entidades, como nome, cidade, local trabalho.

no ner a função “grouped_entities=True” diz para agrupar em uma unica palavra uma entidade em uma, exemplo: “Data Science”

PER:Pessoa/Nome

LOC: Local

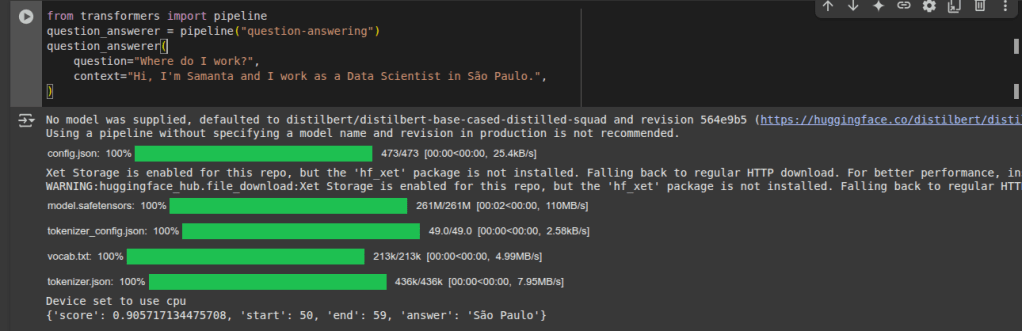
question-answering (extrai a resposta da pergunta)

summarization (sumarização)

Reduz o texto para um texto menor, o resumo escolhe partes importantes do texto

Tradução (translation)

Todos os códigos estão no github: https://github.com/samantaleke/LLM/blob/main/pipeline.py

Text Mining

Extrair informações importantes de textos, em .csv, banco de dados e de informação de grandes volumes textuais, análise de sentimentos, classificação de texto, detecção de fraudes e spam..

A maior parte são dados não estruturados, muita informação, com o Text Mining consegue-se extrair informações relevantes sobre todo esse volume de dados.

Onde pode ser utilizado?

Saúde e pesquisa.

Atendimento ao cliente.

Gestão de Riscos.

Pesquisa acadêmica.

Análise de sentimento.

Filtragem de Spam.

Pré-processamento

Tokenização: Transforma cada palavra ou frase em token

Stopwords: Utiliza somente as palavras importantes. Ex: “e”,”de,”um,”as”, …(português)

Lemmatization: Palavras importantes, aposto do stemming, precisão semantica, deixa a palavra no formato correto: ctz –> para –> certeza

lowercasing – minusculas

remover pontuação – se acaso não tiver valor semantico, se tiver valor semantico não remover.

stemming – reduz a palavra a sua raiz. Ex. fez, fazem, fazer –> para –> fazer.

Dica: iastudio.google.com – mostra quantos token com a pergunta e com a resposta (deixa mais barato a quantidade de token em um modelo generativo):

Exemplo de Libs:

NLTK – toolkit de NLP (https://www.nltk.org/)

wordcloud – https://www.wordclouds.com/

spacy – o que é verbo, o que é artigo… https://spacy.io/

Analise de sentimento:

Separar aspectos positivos e aspectos negativos.

Aspectos positivos: Ex: bom, sabor

Aspectos negativos: Ex: demora, ruim

Aspectos Neutros.

Desafios em NLP

Ambiguidade

A ambiguidade pode ser um desafio em NLP, palavras com mais de 1 sentido. Exemplo: Sonha, sonho dormindo e sonho de doce.

Sarcasmo e Ironia

“Seria ótimo se não fosse tão ruim”

NLP – Análise de Sentimento

TextBlob()

Polaridade:

-1 negativo, 0 neutro, 1 positivo, ou seja, quanto mais perto o valor da polaridade for de -1 mais tende ao negativo, o inverso tambem.

Subjetividade:

0 indica uma informação mais objetiva, baseada em fato.

1 baseada em opinião, subjetividade, não baseada em fato.

Outras bibliotecas mais detalhadas:

VANDER SentmentIntensityAnalyser()

  • pos:o quão positiva é a frase ou documento;
  • neu:o quão neutra é a frase ou documento;
  • neg:o quão é negativa;
  • compound:pontuação geral.

TF-IDC (frequencia do texto):

Avaliar a importância de 1 palavara, combinando a frequencia do termo.

Exemplo: a palavra “xxx” aparece 3 vezes no documento de 100 palavras: TF(xxx) = 3/100 = 0,03

IDF ():

O Quão rara é a palavra

Bag of Words (bow)

Palavras em números, converte palavras em numeros, a unica maneira de utilizar estatisticas, probabilidade no qual os modelos vai compreender.

Vai transformar cada frase em uma linha:

NLP, Text Mining, Sentiment Analysis

Processamento da Linguagem Natural:

Área da linguistica e aprendizado de maquina (ML) relacionado ao entendido de linguagem humana.

Objetivo do NLP

Classificação de sentimento, identificar spam, se tem verbo, substativo, preencher lacunas de textos, extrair respostats baseadas em uma pergunta passada, traduzir o texto para outro idioma.

Tambem engloba outros desafios, como visão computacional, geração da transcrição de áudio e descrição de imagem.